Pourquoi le backoff compte : une tempête de retries peut faire tomber un service
- 15 septembre 2026
- 8 mins de lecture
- Qualité logicielle
Table des matières
J’étais en train de dépanner un problème en production dans un service qui ressemblait à un problème de performance.
Le service se comportait mal sous trafic réel, mais le chemin de code semblait normal. Le CPU était élevé, et les clients voyaient une instabilité intermittente.
Au début, rien d’évident ne sautait aux yeux. Puis j’ai tracé un appel API et j’ai trouvé le vrai problème : le service en amont renvoyait une erreur temporaire parce que les données n’étaient pas encore prêtes.
Un seul appel en échec s’est transformé en une rafale de retries.
La logique de retry était raisonnable en principe, mais l’absence de backoff signifiait que le service continuait à réessayer cette erreur transitoire à pleine vitesse :
1while True:
2    try:
3        response = client.get("/data")
4        break
5    except TransientError:
6        continue
Ce délai manquant était le bug.
Cet article s’appuie sur les idées abordées dans Robustesse logicielle et paradigmes de timeout/retry avec backoff. Cet article explique la théorie. Celui-ci est l’histoire pratique : ce qui se passe lorsqu’une boucle de retry est trop agressive.
Pourquoi le backoff est dangereux
Une boucle de retry n’est pas gratuite. Chaque requête en échec fait plus que simplement déclencher une nouvelle tentative. Elle crée une autre requête, analyse l’erreur, planifie un autre retry, et recommence immédiatement.
Dans une boucle aussi serrée, le service occupe le CPU, la dépendance en amont continue de subir de la pression, et l’ensemble du chemin d’appel devient moins stable.
Le point important est que le problème n’est pas seulement la requête en échec elle-même. Le problème est la fréquence des retries. Quand le service est déjà sous contrainte, réessayer immédiatement peut transformer une erreur transitoire en une situation de surcharge durable.
L’effet est visible à deux endroits : le service devient lourd en CPU parce qu’il tourne en boucle sur les retries, et la dépendance en amont reçoit un débit de requêtes beaucoup plus important qu’il ne devrait.
C’est exactement le comportement que nous voulons éviter.
L’expérience
Le meilleur moyen de le voir clairement est de simuler un petit service qui renvoie une erreur temporaire pendant que ses données sont encore en préparation.
Le laboratoire utilise un service en amont (appelé serveur) qui répond avec un 503 temporaire jusqu’à ce que ses données soient prêtes, un service en aval (appelé client) qui réessaie les requêtes en échec avec un backoff configurable, ainsi qu’une plage de réglages de backoff allant de 0 ms à 2000 ms.
Chaque scénario est exécuté à la suite, et le script enregistre l’utilisation du CPU du client et du serveur.
Le laboratoire couvre 32 combinaisons : huit valeurs de backoff croisées avec quatre niveaux de concurrence. Il est volontairement petit, afin d’illustrer le schéma plutôt que de servir de benchmark de capacité.
Le point de l’expérience n’est pas de produire un benchmark parfait. Il s’agit de rendre l’effet visible : à mesure que le délai entre les retries augmente, la tempête de retries s’affaiblit et le service redevient stable.
Note
Le laboratoire Docker complet est conservé dans le laboratoire GitHub de cet article. L’expérience exécute huit valeurs de backoff (0 à 2000 ms) à quatre niveaux de concurrence du client (1, 2, 4 et 8). Chaque conteneur est limité à un CPU pour que les scénarios soient plus faciles à comparer.
Ce que devraient ressembler les données
La forme attendue est simple : le CPU doit être le plus élevé lorsque les retries se produisent en boucle serrée, puis diminuer à mesure que le délai entre les tentatives augmente. Il s’agit d’une prédiction sur le mécanisme, pas d’une mesure du volume de requêtes ou de la latence.
L’expérience mesure l’utilisation du CPU des conteneurs client et serveur. Elle ne collecte ni le nombre de requêtes, ni le nombre de retries, ni les distributions de latence, de sorte que ces quantités ne doivent pas être déduites des chiffres ci-dessous.
Le service consacre plus de temps aux retries qu’au travail utile. Quand la boucle de retry est trop rapide, le service amplifie l’erreur. Quand la boucle ralentit, l’erreur devient gérable.
Ce que cette exécution a mesuré
Les mesures suivent ce schéma. Chaque cellule ci-dessous est l’usage médian du CPU sur 120 secondes de retries pour une paire de backoff et de concurrence. L’échelle des couleurs est logarithmique parce que les valeurs couvrent près de trois ordres de grandeur.
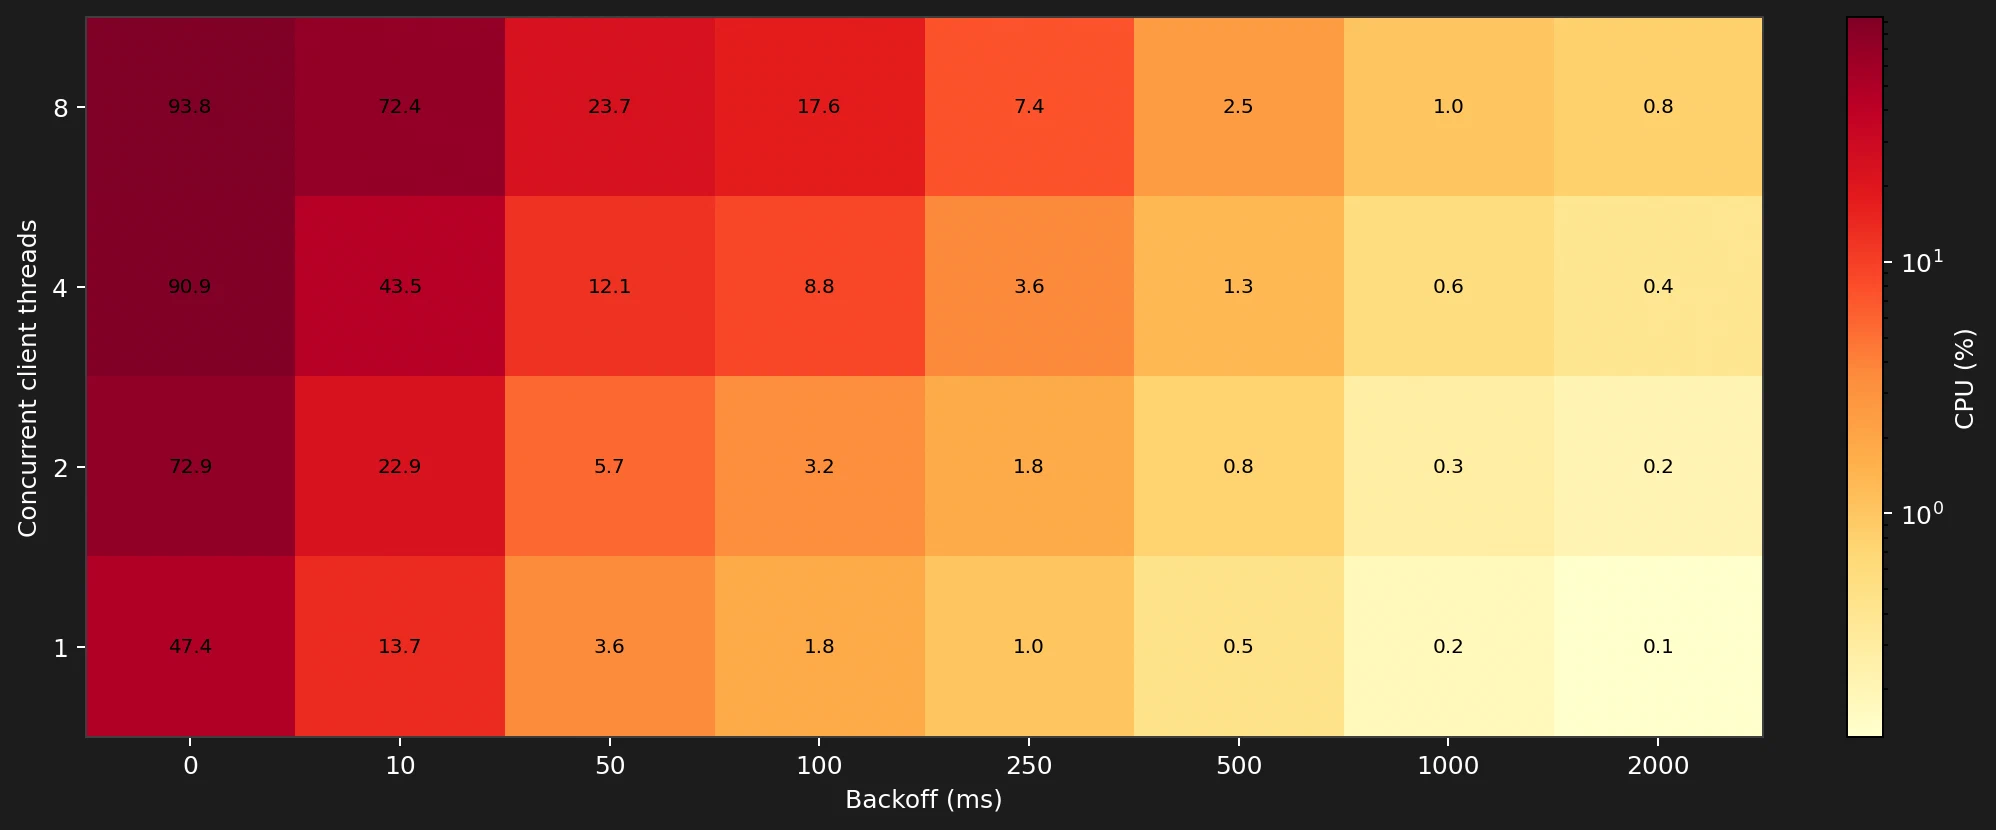
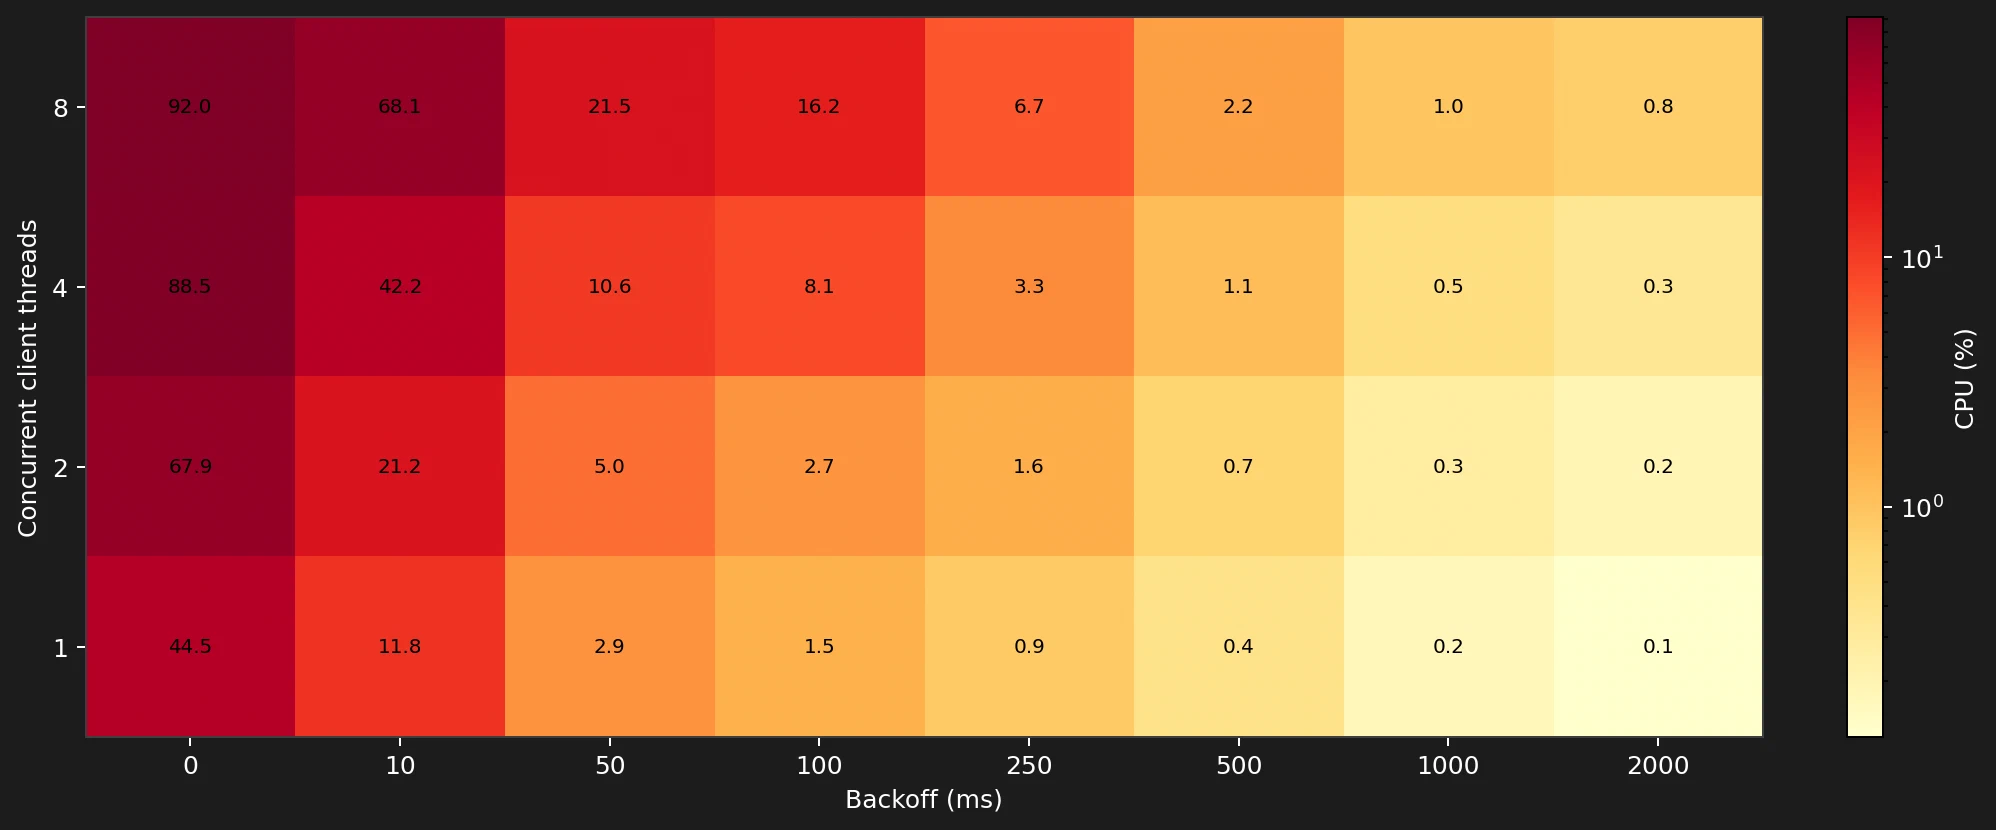
Avec huit threads clients simultanés, la médiane du client tombe de 93,8 % sans backoff à 23,7 % avec un backoff de 50 ms, puis à 0,8 % avec un backoff de 2 secondes. La médiane du serveur tombe de 92,0 % à 21,5 %, puis à 0,8 % sur les mêmes valeurs.
Même un délai de 10 ms fait une différence substantielle à faible concurrence, mais il n’est pas suffisant pour contenir la pression à huit threads simultanés.
Les premiers échantillons montrent aussi pourquoi un résumé seul ne suffit pas.
Le tracé suivant montre des exécutions avec un client à 0 ms, 100 ms et 1000 ms de backoff. Le pic de démarrage initial est visible, mais le niveau de CPU soutenu après le démarrage est la différence importante.
Le collecteur a généré des pseudo-horodatages pendant le traitement de docker stats, de sorte que l’axe horizontal est utile pour comparer la forme des tracés, et non pour lire un temps wall-clock précis.
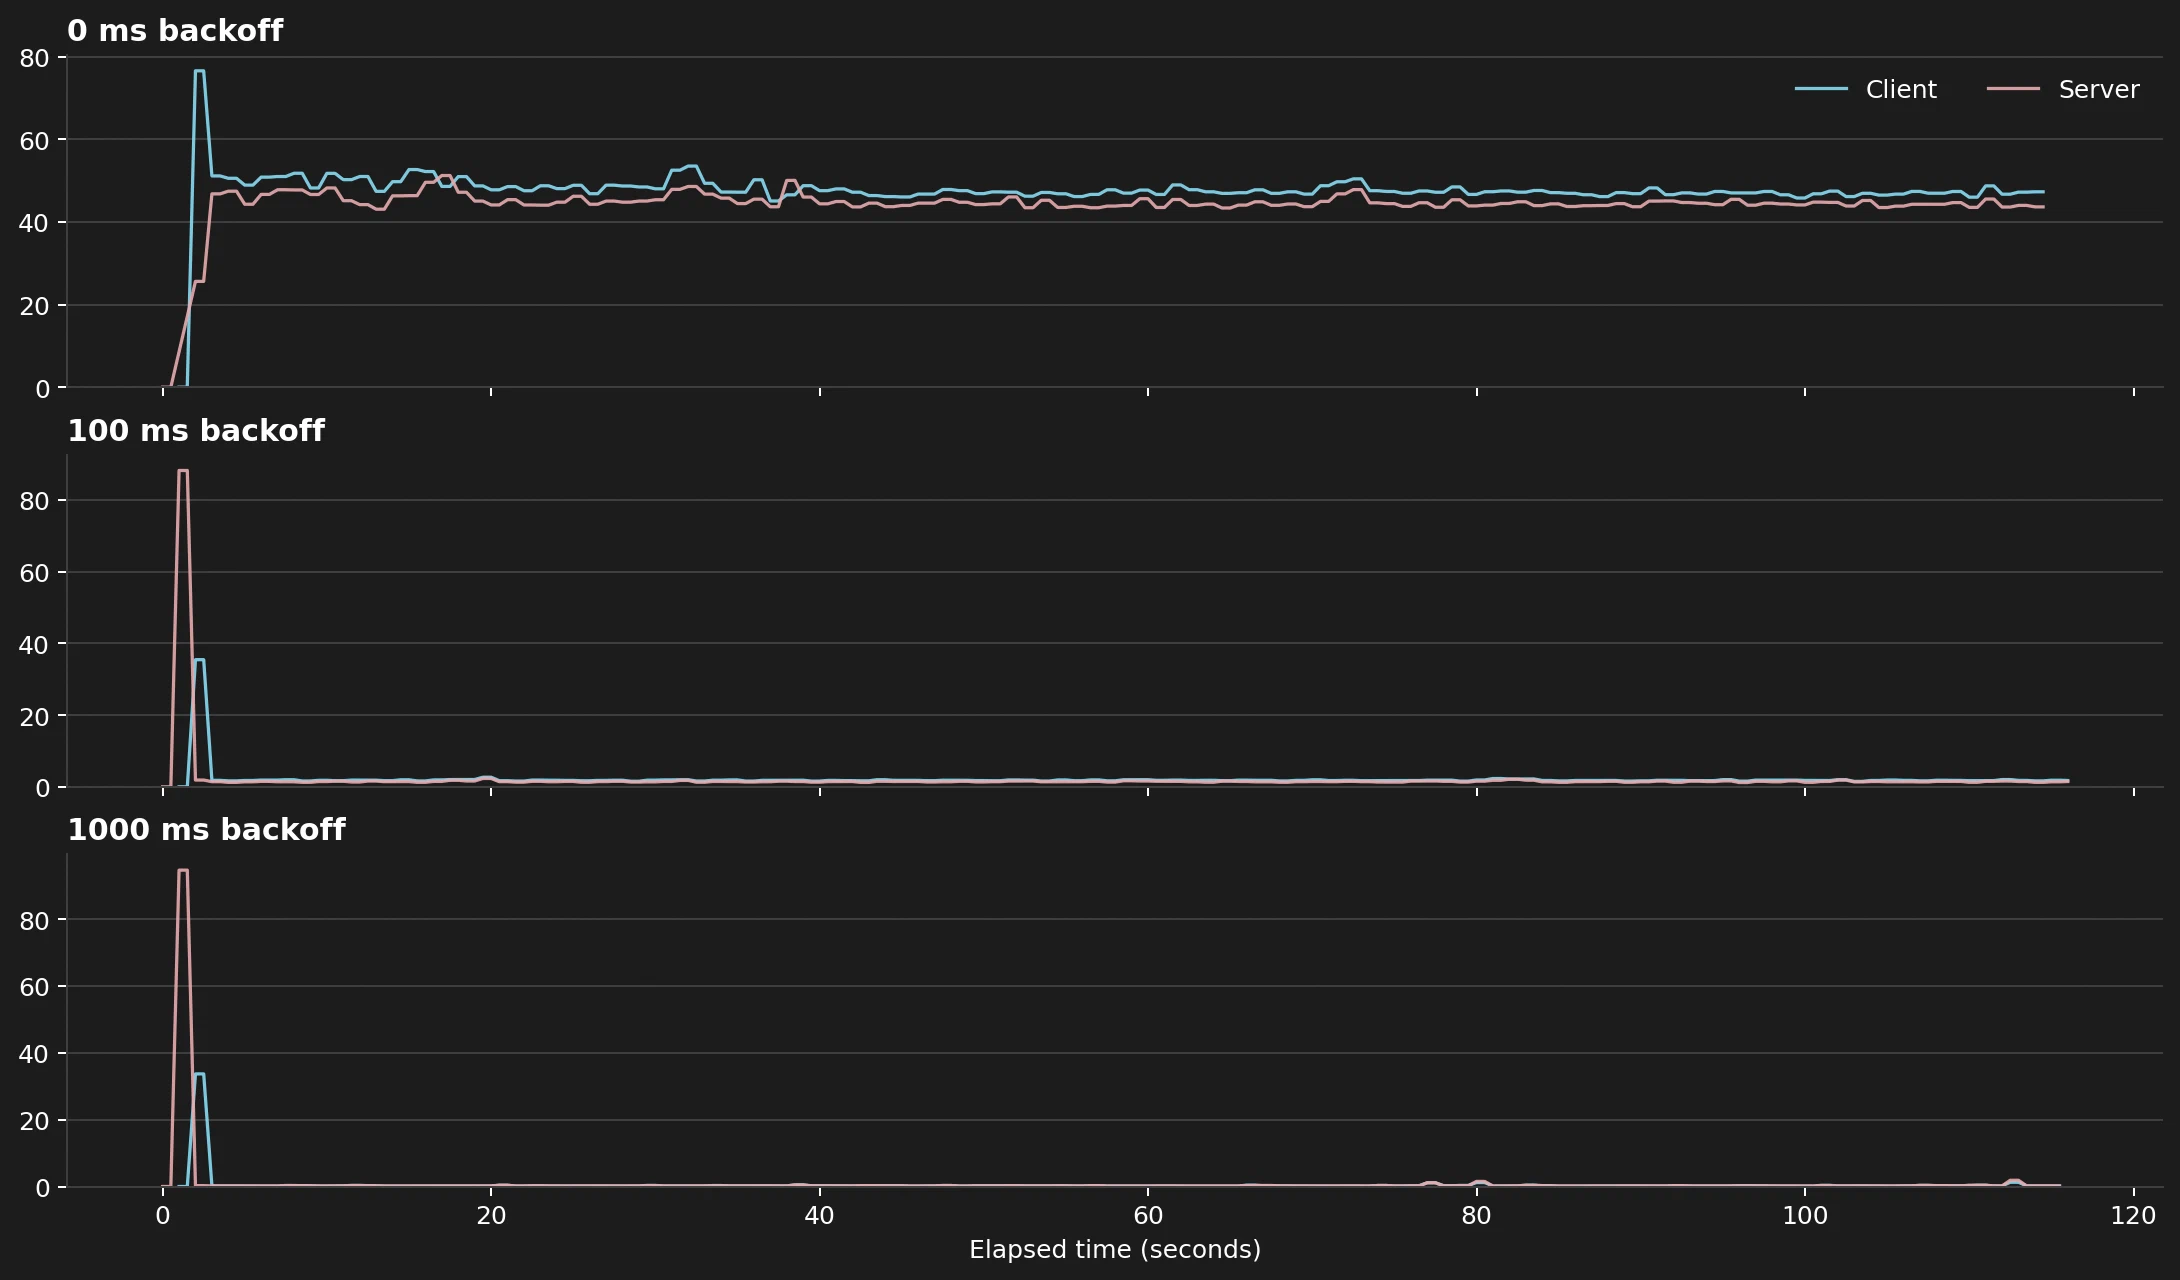
Ces chiffres ne doivent pas être lus comme des limites universelles du CPU. Les conteneurs étaient limités à un CPU chacun, et le résultat dépend de la machine, du runtime, de la charge de requêtes et de la méthode d’échantillonnage. La conclusion utile est la relation suivante : retirer la boucle de retry serrée retire la majeure partie de la pression CPU inutile.
Pourquoi cela compte dans les systèmes réels
La vraie leçon n’est pas « ne pas réessayer ». Il s’agit du fait que réessayer n’est pas gratuit, et qu’une boucle de retry sans backoff peut transformer une erreur temporaire en une surcharge infligée par soi-même.
Si une dépendance est brièvement indisponible ou prépare encore ses données, un service qui réessaie trop agressivement peut créer une boucle chaude locale. Ce service consomme du CPU et peut envoyer à la dépendance en amont une rafale de trafic. Dans un système en production, cette charge supplémentaire peut faire grossir la file d’attente, augmenter la latence et rendre l’erreur initiale plus fréquente. La tempête de retries peut s’alimenter elle-même.
C’est pourquoi le backoff n’est pas un détail de mise en œuvre mineur. C’est une partie de la containment des pannes.
La stratégie de retry doit correspondre au mode de panne. Pour une panne temporaire, un petit délai et un retry peuvent suffire. Pour une dépendance qui continue de se préparer, le backoff doit être explicite. Pour un système sous charge, le jitter et le rate limiting sont souvent nécessaires aussi.
Sans cela, vous ne tolérez pas les pannes. Vous les amplifiez.
Résumé
Je ne me souviens plus de l’utilisation exacte de CPU à l’époque de cet incident, mais je me souviens du schéma.
Une boucle de retry sans backoff peut transformer une seule erreur temporaire de dépendance en un pic de CPU et une hausse locale de charge côté serveur. Le schéma est prévisible : les retries multiplient la pression, et la pression aggrave l’erreur initiale.
La solution n’est pas d’arrêter de réessayer. La solution est de réessayer avec un délai délibéré, et de choisir ce délai en fonction du mode de panne et de la charge du système.
Si vous voulez le mesurer vous-même, utilisez le laboratoire dans https://github.com/buildsoftwaresystems/labs/tree/main/retry-without-backoff-makes-your-service-fall-over et comparez le CPU du client et du serveur pour des valeurs de backoff allant de 0 ms à 2 s.
Les données suffisent généralement à faire comprendre le point sans ambiguïté.
Note
Il s’agit d’un petit laboratoire, pas d’un benchmark de production. Il est conçu pour rendre évident l’effet d’amplification des retries de manière contrôlée.
Bulletin d'information
Abonnez-vous à notre bulletin d'information et restez informé(e).